Computer vision and the path to edge AI
พื้นฐาน Computer Vision พร้อมเว็บเทรน AI 5 ทางเลือก ขั้นตอนส่งออกโมเดลไป Edge ความเป็นส่วนตัว และบรรณานุกรม
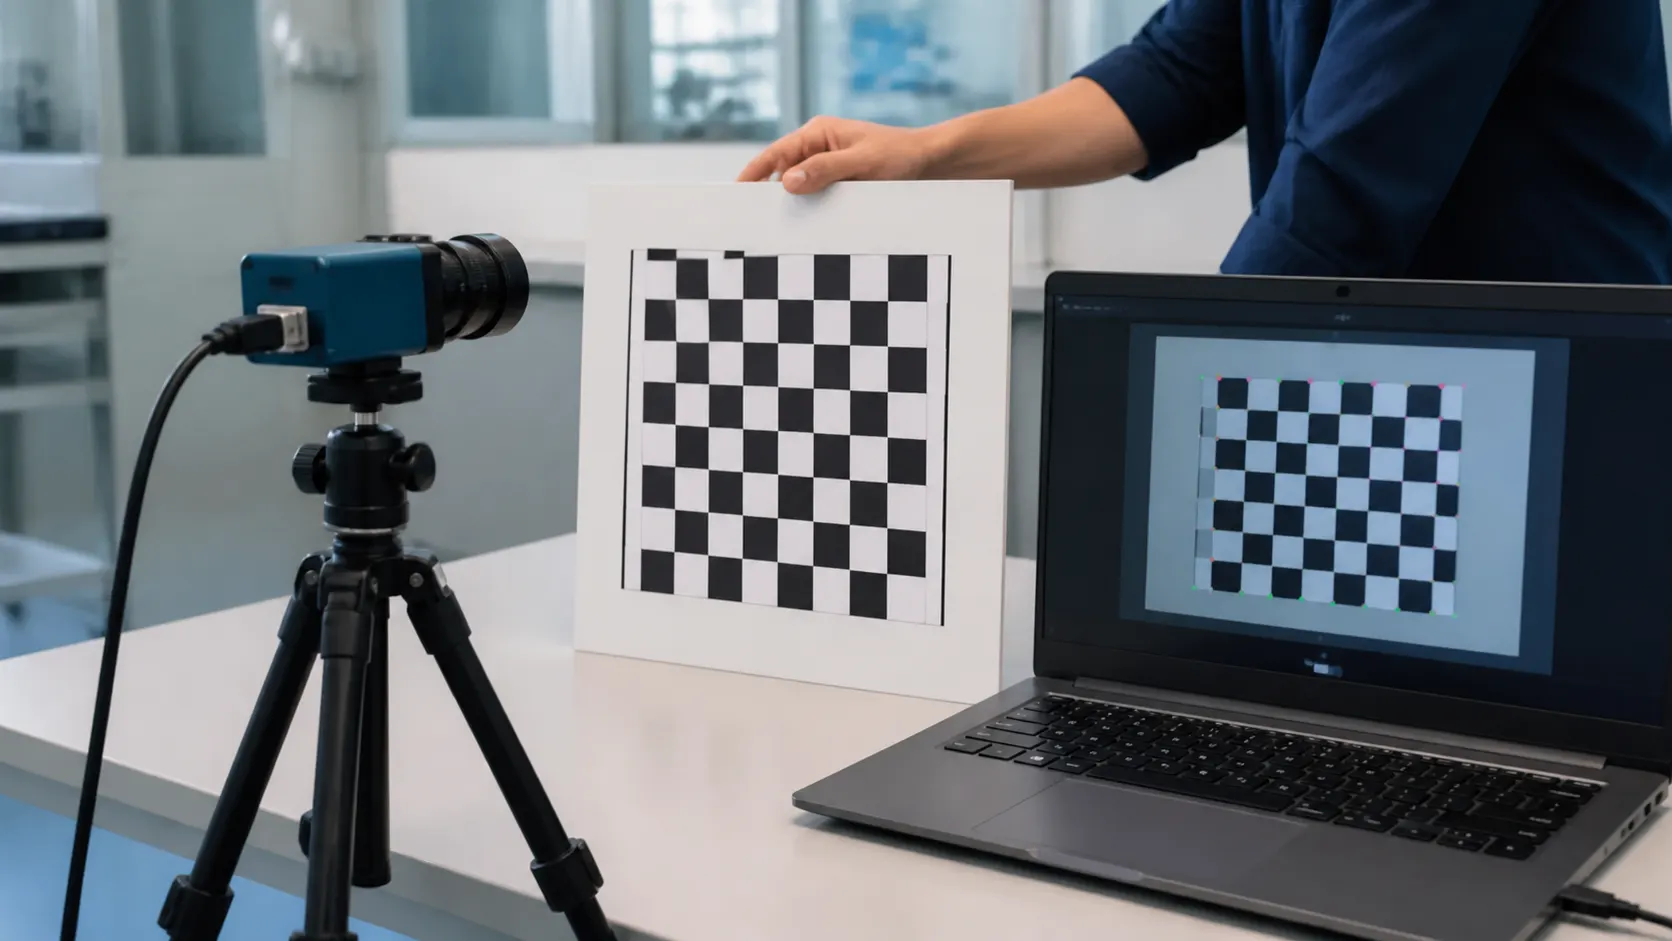
เริ่มจากภาพก่อนเริ่มโมเดล
ภาพเป็นค่าพิกเซลที่มีขนาด ช่องสี และการเข้ารหัส OpenCV ช่วยเรียน resize, color conversion, threshold และ calibration ตรวจ channel order และชนิดข้อมูลก่อนส่งเข้า model เพราะภาพที่แสดงดูถูกต้องอาจมี input format ไม่ตรงที่โมเดลคาด
Calibration และ geometry
กล้อง/เลนส์อาจมี radial และ tangential distortion ใช้ภาพ chessboard หลายมุมมองประมาณ camera matrix และ distortion coefficients แล้วดู reprojection error รายภาพ เก็บความละเอียดและการตั้งค่าที่ใช้ ไม่สมมติ calibration ใช้แทนกล้องทุกตัวได้
แยกข้อมูลเพื่อประเมินจริง
ภาพเฟรมติดกันจากเที่ยวบินเดียวมักคล้ายกันมาก ถ้ากระจายไปทั้ง train และ test ผลอาจดูดีกว่าการใช้งานในฉากใหม่ แยกชุดตามฉาก/เที่ยวบินและเก็บ annotation version ไว้
| ตัวชี้วัด | คำถามที่ตอบ |
|---|---|
| Precision = TP/(TP+FP) | สิ่งที่บอกว่าพบ มีถูกเท่าไร |
| Recall = TP/(TP+FN) | สิ่งที่มีจริง ตรวจพบเท่าไร |
| Latency median/p95 | โดยทั่วไปและช่วงช้าใช้เวลาเท่าไร |
| RAM/VRAM | เครื่องเป้าหมายมีทรัพยากรพอหรือไม่ |
เมื่อ denominator เป็นศูนย์ต้องระบุวิธีจัดการในรายงาน ไม่เติมค่าที่ทำให้ผลดูดี การเปลี่ยน confidence threshold มีผลต่อ precision/recall จึงต้องใช้ชุดข้อมูลเดียวกันเปรียบเทียบ
F17: อ่าน Precision, Recall, F1 และ IoU ให้ตรงงาน
Confidence เป็นคะแนนของโมเดลต่อคำทำนาย ไม่ใช่ accuracy ที่วัดกับคำตอบจริง คะแนน 0.9 ของภาพหนึ่งจึงไม่แปลว่าโมเดลถูก 90% ของทุกภาพ ต้องตรวจการสอบเทียบคะแนนและผลบนชุดทดสอบที่แยกไว้
P = TP / (TP + FP) คือสัดส่วนที่ถูกในสิ่งที่ระบบแจ้งพบ
R = TP / (TP + FN) คือสัดส่วนที่พบจากสิ่งที่มีจริง
F1 = 2PR / (P + R) = 2TP / (2TP + FP + FN)
IoU = พื้นที่ส่วนทับ / พื้นที่ส่วนรวม
| ตัวแปร | ความหมายและหน่วย | ช่วงและแหล่งค่า |
|---|---|---|
| TP | คำทำนายบวกที่ถูก หน่วยตามงาน | จำนวนเต็ม ≥ 0 จาก labels และผล evaluator |
| FP | แจ้งบวกเกินหรือผิด หน่วยตามงาน | จำนวนเต็ม ≥ 0; detection รวมกรอบซ้ำที่จับคู่ไม่ได้ |
| FN | ของจริงที่พลาด หน่วยตามงาน | จำนวนเต็ม ≥ 0 จากคำตอบจริงที่จับคู่ไม่ได้ |
| P, R, F1 | สัดส่วน ไม่มีหน่วย | 0–1 เมื่อส่วนหารนิยามได้ |
| พื้นที่ส่วนทับ/ส่วนรวม | พื้นที่กรอบหรือ mask | หน่วยเดียวกัน เช่น pixel²; ส่วนรวม > 0 |
| IoU, threshold | สัดส่วน ไม่มีหน่วย | 0–1; เก็บค่าตัด confidence และ IoU แยกกัน |
Classification นับคำตอบรายภาพหรือรายตัวอย่างตามคลาสที่ประกาศ; semantic segmentation นับรายพิกเซลและใช้ mask IoU; object detection ต้องจับคู่กรอบทำนายกับ ground truth คลาสเดียวกันแบบหนึ่งต่อหนึ่ง ที่ผ่าน IoU threshold ก่อนนับ TP/FP/FN ระบุลำดับจับคู่และวิธีจัดการ ignore/crowd ตาม evaluator ด้วย กรอบทำนายสองกรอบทับวัตถุเดียวไม่ใช่ TP สองครั้ง ส่วน instance segmentation ต้องจับคู่แต่ละ instance ตาม mask ของมัน
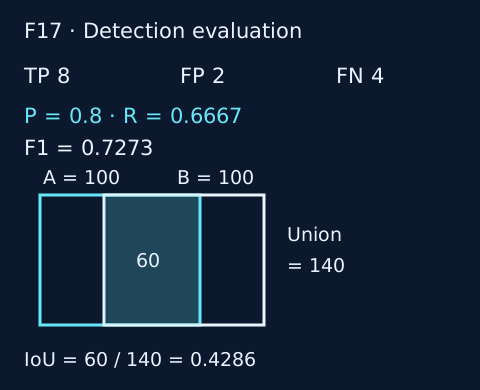
ตัวอย่างนี้ล็อกคลาสพัสดุและ confidence threshold ไว้แล้ว หลัง evaluator จับคู่ได้ TP = 8, FP = 2, FN = 4 จึง P = 8/(8+2) = 0.8, R = 8/(8+4) = 2/3 ≈ 0.6667 และ F1 = 16/(16+2+4) = 8/11 ≈ 0.7273 ทั้งหมดไม่มีหน่วย คูณ 100 เพื่อแสดงเป็นเปอร์เซ็นต์
ตัวอย่าง IoU แยกจากยอดนับข้างต้น: กรอบ A และ B มีพื้นที่กรอบละ 100 pixel² ส่วนทับ 60 pixel² ดังนั้นส่วนรวม = 100+100−60 = 140 pixel² และ IoU = 60/140 = 3/7 ≈ 0.4286 หากตั้ง IoU threshold = 0.5 กรอบคู่นี้ยังไม่ผ่าน แม้ confidence สูง
AP และ mAP ต้องประเมินหลาย threshold
AP สรุปความสัมพันธ์ precision–recall จากคะแนนที่เรียงลำดับและการเปลี่ยนจุดตัดตามวิธี evaluator ส่วน mAP เฉลี่ย AP ตามคลาสและชุด IoU ที่ระบุ ไม่ใช่ (P+R)/2 ค่า mAP50 ใช้ IoU 0.50 ส่วน mAP50–95 รวม IoU 0.50 ถึง 0.95 เพิ่มครั้งละ 0.05 จึงเทียบกันโดยไม่ระบุชื่อ metric ไม่ได้ ตัวอย่างสมมติ AP ของสองคลาสภายใต้ evaluator/IoU เดียวกันเป็น 0.6 และ 0.8 จะได้ mAP = (0.6+0.8)/2 = 0.7 แต่หา AP ทั้งสองจาก TP/FP/FN ณ threshold เดียวไม่ได้
เมื่อตัวหารเป็นศูนย์ บทฝึกนี้รายงาน ไม่กำหนด (N/A) พร้อมยอดนับจริง; ถ้าต้องใช้ evaluator ที่แทนด้วย 0 หรือไม่นับคลาสนั้น ต้องเปิดเผยนโยบายและ averaging แบบ micro/macro/weighted ไม่ผสมผลต่างนโยบาย การไม่มี prediction แต่มีของจริงทำให้ precision ไม่กำหนด, recall = 0 และ F1 จากสูตรนับ = 0 ไม่ถือเป็นคะแนนสมบูรณ์
นิยาม P/R/F1 และ averaging อ้างอิง scikit-learn Model Evaluation (S16); detection AP/mAP อ้างอิง Ultralytics YOLO Performance Metrics (S17) ตรวจ 26 กันยายน 2569 เมื่อทดลองจริงให้บันทึกเวอร์ชัน library/evaluator, annotation, matching, IoU, confidence และคลาสที่รวมในผล ตัวเลขในบทเป็นโจทย์สังเคราะห์
แบบฝึกและเฉลย
คง TP = 8 และ FN = 4 แต่ลด FP เหลือ 0 จะเปลี่ยน P/R/F1 อย่างไร?
เฉลย F17
P = 8/8 = 1, R = 8/12 = 2/3 และ F1 = 16/(16+0+4) = 0.8 จึง precision ดีขึ้นแต่ยังพลาดของจริง 4 ชิ้น ยอมรับค่าปัด ±0.0001 สำหรับสัดส่วน ไม่ใช้ confidence เฉลี่ยแทนคำตอบ
ใช้ เครื่องมือฝึกเดิม และอ่าน การแบ่งชุดข้อมูล กับ การวัด latency ประกอบ
จาก PC ไปสู่บอร์ดจริง
เริ่ม inference บน CPU ด้วย OpenCV/PyTorch/ONNX Runtime แล้วค่อยทดลอง GPU ส่วน Picamera2 ต้องใช้ Raspberry Pi และ camera stack ที่รองรับ; jetson-inference ใช้กับ Jetson/JetPack ที่ตรงกัน ความเร็วบน desktop ไม่ใช่ benchmark ของบอร์ด
สิทธิ์ของโค้ด โมเดล และข้อมูล
แยก license ของ library, model weights, dataset และบริการ cloud Ultralytics มี AGPL/Enterprise; Roboflow Public เปิด data/models ส่วน Colab มี quota ที่ไม่รับประกัน GPU ตรวจขอบเขตก่อนเลือกเครื่องมือสำหรับข้อมูลส่วนตัว
เว็บเทรน AI เพื่อนำไปตรวจจับวัตถุบนโดรน
ตรวจข้อมูลผู้ให้บริการเมื่อ 7 กันยายน 2569 ส่วนนี้หมายถึงการตรวจจับวัตถุในภาพจากกล้อง เช่น กล่องพัสดุ ห่วงชูชีพ หรืออุปกรณ์สำรวจ ผลตรวจจับยังไม่ใช่คำสั่งให้โดรนบินเข้าหา หยิบจับ หรือติดตามวัตถุโดยอัตโนมัติ
เลือก Object detection เมื่อต้องรู้ว่า “มีวัตถุอะไร อยู่ตรงไหน” ส่วน Image classification ตอบประเภทของภาพโดยรวม จึงใช้แทนกรอบตำแหน่งวัตถุหลายชิ้นไม่ได้ ไฟล์ที่นำไปใช้งานคือ โมเดลที่ฝึกแล้ว พร้อมรายชื่อคลาสและค่าการเตรียมภาพ ไม่ใช่การคัดลอกโฟลเดอร์ภาพฝึกลงโดรน
เลือกเครื่องมือให้ตรงงาน
| เว็บทางการ | เหมาะกับ | ทางไปสู่โดรน / ข้อจำกัด |
|---|---|---|
| Edge Impulse Studio | เริ่ม Object detection และเตรียมใช้งานบนอุปกรณ์ Edge | เลือก deployment ตามบอร์ด เช่น C++ library หรือ Linux .eim; FOMO ให้จุดศูนย์กลาง ไม่ใช่ขนาดกรอบวัตถุ [1–3] |
| Ultralytics Platform | วาดกรอบ เทรน YOLO และส่งออกโมเดล | มี ONNX, TensorRT และรูปแบบอื่นตามโมเดล/เป้าหมาย ต้องตรวจ runtime และใบอนุญาต [4–6] |
| Roboflow | จัดชุดภาพ วาดกรอบ ตรวจข้อมูล และเทรน | แยก dataset export จาก model weights export; ความสามารถดาวน์โหลด weights ขึ้นกับโมเดลและแผน [7–9] |
| Google Teachable Machine | ผู้เริ่มต้นเรียน Image classification | ทดลองผ่านกล้องและนำโมเดลไปใช้ในโปรแกรมได้ แต่ Image Project ไม่ใช่ตัวตรวจจับกรอบหลายวัตถุ [10–11] |
| Google Colab | ผู้ที่พร้อมใช้ Python และปรับขั้นตอนฝึกเอง | เป็นสมุดโน้ตคำนวณบน cloud ต้องใช้โค้ดฝึก เช่น Ultralytics; มีข้อจำกัดทรัพยากรและไม่รับประกัน GPU [12] |
แนวทางเริ่มต้นที่แนะนำ: ใช้ Edge Impulse ถ้าต้องการเห็นขั้นตอนจนถึงบอร์ด Edge ในระบบเดียว หรือ Ultralytics Platform ถ้าต้องการเรียน YOLO และส่งออกโมเดลหลายรูปแบบ ใช้ Roboflow เมื่อเน้นจัดการภาพและ annotation โดยตรวจสิทธิ์ export ก่อนเริ่มงาน ส่วน Teachable Machine เหมาะกับบทปูพื้นฐานการจำแนกภาพ
Edge Impulse: จากรูปภาพสู่บอร์ด Edge
- สร้างบัญชีและ project ตรวจการตั้งค่า Private ก่อนอัปโหลดภาพ แล้วเลือกงาน Object detection
- เพิ่มภาพและวาด bounding box ให้แต่ละคลาส แยกภาพทดสอบจากคนละฉากหรือรอบการถ่าย
- สร้าง impulse เลือกการประมวลผลภาพและ learning block แล้ว Train และ Model testing
- ไป Deployment เลือก target ที่รองรับ ทดลองผลบนคอมพิวเตอร์หรือ Linux ก่อนนำ package ไปบอร์ดจริง
มี Developer plan สำหรับทดลองและเงื่อนไขแยกจาก Enterprise ข้อมูลใน project แบบ private ยังถูกประมวลผลโดยบริการ cloud ตามเงื่อนไขผู้ให้บริการ ไม่ได้หมายถึงทำงานเฉพาะในเครื่อง หากเลือก FOMO ต้องเข้าใจว่าผลเป็นจุดศูนย์กลางและมีข้อจำกัดเมื่อวัตถุอยู่ชิดกัน [1–3, 13]
เปิด Studio → · คู่มือ Deployment · GitHub Linux Python SDK
Ultralytics Platform: เทรนและส่งออก YOLO
- สร้าง dataset/project ตรวจ visibility แล้วอัปโหลดภาพและกำหนดคลาส เช่น
parcel - วาดกรอบวัตถุ ตรวจ annotation และแยก train/validation/test ก่อนเลือกโมเดลและเริ่ม Train
- ดูผลประเมินและภาพที่ตรวจผิด เก็บ test set ไว้ตรวจรุ่นใหม่โดยไม่ใช้ฝึก
- ดาวน์โหลด weights หรือ Export รูปแบบที่ตรงกับเครื่อง เช่น ONNX สำหรับ runtime ที่รองรับ แล้วทดสอบกับวิดีโอใหม่
ตรวจค่าใช้บริการฝึกและสิทธิ์ของโมเดลก่อนเริ่ม ใบอนุญาต AGPL-3.0 กับ Enterprise มีเงื่อนไขต่างกัน การส่งออกสำเร็จไม่ได้รับรองความเร็วหรือความเข้ากันได้กับบอร์ดทุกตัว โดยเฉพาะ TensorRT ต้องตรวจรุ่น runtime และฮาร์ดแวร์เป้าหมาย [4–6]
เปิด Platform → · คู่มือส่งออก · GitHub Ultralytics
Roboflow: จัดข้อมูลและเทรนพร้อมตรวจเงื่อนไขส่งออก
- ตรวจแผนและความเป็นส่วนตัวของ workspace ก่อนสร้าง Object Detection project
- อัปโหลดภาพ Annotate กรอบและคลาส แล้วสร้าง dataset version พร้อมชุดทดสอบ
- เลือกโมเดลที่รองรับ Train และตรวจผลจากภาพที่โมเดลยังไม่เคยเห็น
- ตรวจ Supported Models ว่าโมเดลและแผนนี้ดาวน์โหลด weights ได้หรือใช้ Roboflow Inference บนฮาร์ดแวร์ได้อย่างไร ก่อนเลือกวิธี deploy
เอกสารระบุว่า free plan เปิด dataset และ model บน Universe ส่วน paid plans/trials มีข้อมูล private ตามเงื่อนไขแผน อย่าใช้โครงการสาธารณะกับภาพที่ไม่ต้องการเผยแพร่ การกด Export Dataset ได้ไฟล์ภาพและ labels ไม่ใช่หลักฐานว่าโหลดโมเดลที่เทรนแล้วได้ [7–9]
เปิด Roboflow → · ตรวจโมเดลและการส่งออก · GitHub Inference
Teachable Machine: เรียนการจำแนกภาพก่อนตรวจจับตำแหน่ง
- เปิด Image Project สร้างคลาส เช่น “มีพัสดุ” และ “ฉากอื่น”
- เพิ่มภาพหลายมุมและหลายฉาก แล้ว Train และลองภาพใหม่ใน Preview
- เปิด Export Model เลือกรูปแบบที่โปรแกรมปลายทางรองรับ เช่น TensorFlow.js และดาวน์โหลดไฟล์พร้อม labels
- ทดลองบนคอมพิวเตอร์ก่อน หากต้องการตำแหน่งหลายวัตถุ ให้เปลี่ยนไปใช้ Object detection
เว็บระบุว่าสามารถเลือกใช้แบบ on-device โดยข้อมูลกล้อง/ไมโครโฟนไม่ออกจากเครื่องได้ แต่การบันทึกขึ้น cloud หรือเผยแพร่ลิงก์เป็นอีกการกระทำหนึ่งที่ต้องตรวจแยก ไม่เหมารวมว่าทุกวิธีบันทึกเป็น local [10–11]
เปิด Teachable Machine → · GitHub ตัวอย่าง Image library
Colab: ฝึกผ่าน Python เมื่อพร้อมปรับโค้ด
- เปิด notebook ที่ตรวจที่มาได้ เช่นตัวอย่างใน GitHub ทางการของไลบรารี และอ่านโค้ดก่อน Run all
- เตรียมข้อมูลที่มีสิทธิ์ใช้ ระบุ dataset split แล้วเลือก runtime ตามทรัพยากรที่ได้รับ
- ติดตั้งเวอร์ชันที่กำหนด เทรนและประเมินด้วย test set แยกต่างหาก
- ดาวน์โหลด weights, labels, configuration และผลประเมินก่อน runtime สิ้นสุด แล้วทดสอบ inference บน Windows/Linux
Colab ไม่ใช่เว็บวาดกรอบและเทรนครบชุดแบบอัตโนมัติ ทรัพยากรฟรีมีข้อจำกัดและเปลี่ยนได้ ระวังสิทธิ์ Drive และข้อมูลใน notebook ที่แชร์ ไม่ใส่ API key ลงเซลล์ที่เผยแพร่ [12]
เปิด Colab → · ข้อจำกัดและ FAQ
ตรวจความปลอดภัยก่อนอัปโหลดภาพ
รายการนี้คัดจากโดเมนผู้ให้บริการและเอกสารทางการที่ตรวจได้ ไม่ได้เป็นการรับรองว่าไม่มีความเสี่ยงหรือผ่านการทดสอบเจาะระบบ ให้เริ่มจากภาพวัตถุที่สร้างหรือถ่ายเองและไม่มีข้อมูลอ่อนไหว แล้วตรวจสิ่งต่อไปนี้ก่อนใช้ข้อมูลจริง
- ตรวจว่า project, dataset และ model เป็น private ตามที่ต้องการ รวมถึงสิทธิ์ผู้ร่วมงานและเงื่อนไขเมื่อเปลี่ยนแผน
- อ่านนโยบายการใช้ข้อมูล การลบและสำรองข้อมูล โดยเฉพาะภาพบุคคล พิกัด EXIF และภาพพื้นที่ที่มีข้อจำกัด; ข้อมูล private บน cloud ยังต้องส่งไปประมวลผลกับผู้ให้บริการ
- เข้าเว็บจากลิงก์ทางการ ใช้รหัสผ่านเฉพาะบัญชี เปิด MFA เมื่อบริการรองรับ และเก็บ API key นอกโค้ดสาธารณะ
- ตรวจ license ของข้อมูล โค้ด weights และบริการแยกกัน รวมทั้งสิทธิ์ใช้งานเชิงพาณิชย์และการแจกโมเดล
Ultralytics มีนโยบายที่แยก customer content ออกจากเนื้อหาที่ผู้ใช้สมัครใจเปิดสาธารณะ ส่วน Edge Impulse ระบุการประมวลผลและ Usage Data ในเงื่อนไขบริการ ต้องอ่านให้ตรงประเภทบัญชีของตน [6, 13–14]
ขั้นตอนย้ายโมเดลจากเว็บไปยังโดรน
ภาพและกรอบกำกับ → ฝึก → ประเมิน → ส่งออกโมเดล → ทดสอบ PC → ทดสอบบอร์ดและกล้อง → เชื่อมระบบโดรน
- เลือกงานตัวอย่าง เช่นตรวจกล่องพัสดุ เก็บภาพหลายระยะ มุม แสง และภาพที่ไม่มีวัตถุเป้าหมาย อย่าใช้แต่ภาพสินค้าใกล้ ๆ หากกล้องจริงจะมองจากด้านบน
- ก่อนฝึก ตรวจว่าบอร์ดหรือ SDK ของโดรนรับโมเดลแบบใด โดรนสำเร็จรูปบางรุ่นไม่เปิดให้เพิ่มโมเดลเอง
- ส่งออกไฟล์โมเดล พร้อม labels, input size, RGB/BGR, normalization และวิธี post-processing เก็บเลขเวอร์ชันและ license เพื่อให้รันซ้ำได้
- เปิดวิดีโอที่บันทึกไว้บน Windows/Linux ตรวจกรอบและจำนวนวัตถุ วัด precision/recall, latency p95 และทรัพยากร แล้วเปรียบเทียบก่อน/หลัง quantization
- นำ package ไป companion computer เช่นบอร์ด Linux ที่รองรับ กล้องส่งภาพเข้าโปรแกรม inference ซึ่งคืนคลาส confidence และตำแหน่งในภาพ เริ่มจากแสดงผลหรือบันทึกผลบนโต๊ะทดลอง
- เชื่อมต่อซอฟต์แวร์โดรนตาม SDK/ROS ที่ระบบรองรับหลังทดสอบบอร์ด ตำแหน่งพิกเซลในภาพยังไม่ใช่พิกัดโลกหรือระยะถึงวัตถุ ต้องมี calibration และข้อมูลเรขาคณิตเพิ่มเติม [15]
หากประมวลผลวิดีโอที่สถานีภาคพื้นแทนบอร์ดบนลำ ต้องทดสอบความหน่วงและการขาดหายของสัญญาณด้วย ส่วนการรันโมเดลบนอุปกรณ์แบบ offline ต้องตรวจจริงโดยตัดอินเทอร์เน็ต เพราะการแสดงผลผ่าน hosted API ยังพึ่งเครือข่ายอยู่
สถานะการตรวจ: ตรวจคู่มือและเงื่อนไขผู้ให้บริการแล้ว ยังไม่ได้อัปโหลดภาพ เทรนโมเดล หรือทดสอบบนโดรนจริงในงานวิจัยรอบนี้ ไม่รับรองว่าไฟล์เดียวใช้กับโดรนทุกยี่ห้อได้
บรรณานุกรม: เว็บเทรน AI และการนำไปใช้
รายการเว็บไซต์ไม่ระบุปีใช้ “ม.ป.ป.” สืบค้นทุกรายการวันที่ 7 กันยายน 2569
- Edge Impulse. (ม.ป.ป.). Object detection.
- Edge Impulse. (ม.ป.ป.). Deployment.
- Edge Impulse. (ม.ป.ป.). Introducing the Developer Plan.
- Ultralytics. (ม.ป.ป.). Trained Model Management.
- Ultralytics. (ม.ป.ป.). Model Export with Ultralytics YOLO.
- Ultralytics. (ม.ป.ป.). Licensing.
- Roboflow. (ม.ป.ป.). Create a Project.
- Roboflow. (ม.ป.ป.). Supported Models.
- Roboflow. (ม.ป.ป.). Pricing and Plans.
- Google Creative Lab. (ม.ป.ป.). Teachable Machine.
- Google Creative Lab. (ม.ป.ป.). Teachable Machine Image Library.
- Google. (ม.ป.ป.). Colaboratory Frequently Asked Questions.
- Edge Impulse. (ม.ป.ป.). Developer Plan Terms of Service และ Privacy Policy.
- Ultralytics. (2026, 22 มิถุนายน). Privacy Policy.
- PX4. (ม.ป.ป.). Companion Computers — User Guide v1.14. ใช้อ้างอิงการแยกหน้าที่ flight controller และ companion computer; ตรวจคู่มือรุ่นที่ใช้ก่อนเชื่อมระบบจริง
อ่านต่อและแหล่งอ้างอิง
- เอกสารตั้งต้น: DTI, Computer_vision_v1
- OpenCV camera calibration
- ONNX Runtime Python
- Ultralytics licensing
- Computer Vision และการทำแผนที่เดิม
- Embedded AI และ ROS
เนื้อหานี้เรียบเรียงจากเอกสารที่ DTI เอื้อเฟื้อและแหล่งอ้างอิงข้างต้น ตัวอย่างตัวเลขเป็นกรณีเพื่อการเรียนรู้ อ่านกิตติกรรมประกาศและที่มาของเนื้อหา
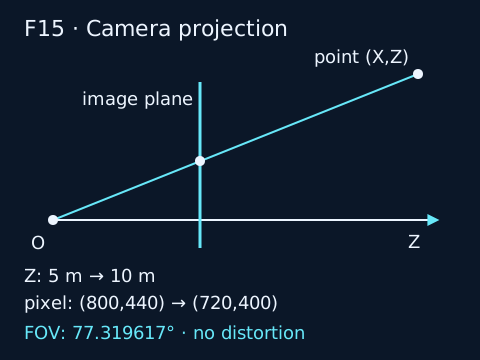
F15: จุดสามมิติลงพิกเซลที่ไหน
| ตัวแปร | ความหมายและหน่วยเข้า → ออก | ช่วง/แหล่งค่า |
|---|---|---|
| X,Y,Z | พิกัดในกรอบกล้อง m (เข้า) | finite, Z > 0; X ขวา Y ลง Z หน้า |
| fx,fy | focal length ในแกนภาพ px (เข้า) | > 0; calibration ที่ความละเอียดเดียวกัน |
| cx,cy | principal point px (เข้า) | finite; ไม่บังคับเป็นศูนย์กลางภาพ |
| S,f | ความกว้างเซนเซอร์และ focal length mm (เข้า) | > 0; หน่วยเดียวกันและ active sensor เดียวกัน |
| u,v,FOV | จุดภาพ px และมุมรับภาพแนวนอน deg (ออก) | finite; จุดอาจอยู่นอกภาพได้; 0 < FOV < 180° |
ระดับประยุกต์ · คำถาม: จุดในกรอบกล้องจะฉายเป็นพิกเซลใด? ใช้ pinhole แบบไม่มี distortion ตาม OpenCV 4.10.0
u = fx X/Z + cx; v = fy Y/Z + cy
FOV_horizontal = 2 atan(S/(2f)) × 180/π
X/Z ไร้หน่วย จึงคูณ fx แล้วเป็น px; atan ให้ rad ก่อนแปลงเป็น deg สูตร FOV นี้สมมติกรอบรับภาพสมมาตรรอบแกนแสง ต้องไม่ใช้เมื่อ crop เยื้องแกนโดยไม่แก้เรขาคณิต ตัวอย่างเป็นกล้องสังเคราะห์ ไม่มีรุ่นฮาร์ดแวร์จริง
ต้องแปลง world point เข้ากรอบกล้องก่อนใช้สูตร Z=0 หารไม่ได้และ Z<0 อยู่หลังกล้อง ไม่รองรับ fisheye/distortion เมื่อ resize/crop ต้องปรับ intrinsic ให้ตรงภาพใหม่ FOV เป็นขอบเรขาคณิต ไม่รับรองการตรวจพบวัตถุ
ตัวอย่างแทนค่า
ให้ X=1 m,Y=0.5 m,Z=5 m, fx=fy=800 px,cx=640 px,cy=360 px ได้ u=800×1/5+640=800 px และ v=800×0.5/5+360=440 px แยกคำนวณ FOV จาก S=12.8 mm,f=8 mm: 2atan(0.8)=1.349481884 rad=77.319617° (ภาพ1280×720 px, active sensor12.8×7.2 mm จึงตรงกับ fx=fy=800 px)
แบบฝึกเปลี่ยนค่า
เพิ่ม Z เป็น10 m โดยคง X,Y และกล้องเดิม จุดภาพและ FOV เปลี่ยนอย่างไร?
เปิดเฉลย F15
u=720 px,v=400 px ระยะจาก (640,360) ลดครึ่งหนึ่ง ส่วน FOV=77.319617° คงเดิม ยอมรับ ±0.001 px และ ±0.000001°
อ้างอิง: OpenCV 4.10.0 — Camera Calibration and 3D Reconstruction (P3E06); ตรวจ 26 กันยายน 2569
ดาวน์โหลดชุดตรวจคำตอบสูตรพื้นฐาน (JSON) · ข้อมูลสังเคราะห์พร้อมหน่วย ใช้เปรียบเทียบผลคำนวณของตนเอง
ดาวน์โหลดชุดฝึกสูตรวิศวกรรมและเซนเซอร์ (CSV/JSON พร้อมเฉลย) · ข้อมูลสังเคราะห์สำหรับฝึกคำนวณและตรวจสมมติฐาน