เตรียมและแบ่งชุดข้อมูล
โมเดลเรียนได้เท่าที่ข้อมูลและ labels สนับสนุน ต้องกำหนดวัตถุที่จะตรวจ ขอบเขตภาพ และสิทธิ์ก่อนรวบรวม แยกข้อมูลตามกลุ่มที่อาจคล้ายกัน เช่น เที่ยวบินหรือสถานที่ ก่อนใช้ validation เลือกค่าและพัก test ไว้
A01 · บทฝึกและกรณีศึกษา
โมเดลเรียนได้เท่าที่ข้อมูลและ labels สนับสนุน ต้องกำหนดวัตถุที่จะตรวจ ขอบเขตภาพ และสิทธิ์ก่อนรวบรวม แยกข้อมูลตามกลุ่มที่อาจคล้ายกัน เช่น เที่ยวบินหรือสถานที่ ก่อนใช้ validation เลือกค่าและพัก test ไว้
อ่านสูตร ตัวอย่างคำนวณ และแบบฝึกเพิ่มเติม ↓
ก่อนเริ่มเรียน
ใช้คอมพิวเตอร์ Windows หรือ Linux อ่าน CSV ด้วยโปรแกรมตารางหรือ text editor และบันทึกไฟล์งานของตนแยกจากต้นฉบับ ชุด Python พื้นฐานใช้ standard library; โปรแกรม AI และ simulator จริงมีขั้นตอนติดตั้งแยก
เมื่อจบบทนี้
- จัดสิทธิ์ labels และที่มาของภาพเป็น data card
- แยก train/validation/test ตามหน่วยภารกิจเพื่อลดข้อมูลรั่ว
โจทย์และขั้นตอนลงมือทำ
โครงงานตรวจกล่องพัสดุในพื้นที่ฝึกที่ได้รับอนุญาต มีภาพหลายเฟรมจากเที่ยวบินเดียวกัน แสงต่างกัน และกล่องเล็กจนผู้กำกับภาพบางคนไม่แน่ใจ
แตก ZIP แล้วเปิด A01-guide.md และ A01-worksheet.csv เก็บสมมติฐานกับผลที่ตรวจได้แยกกัน ช่องว่างในใบงานหมายถึงต้องเก็บข้อมูล ไม่ใช่ผ่านแล้ว
- ทำ data card: ผู้ถ่าย/สิทธิ์ วัตถุประสงค์ พื้นที่ที่ครอบคลุม สิ่งที่ห้ามนำไปอ้าง และวิธีเก็บสำเนา
- เขียน label guide ระบุกรอบวัตถุที่บังกัน/เล็ก/ไม่แน่ใจ ให้คนสองคนลองกำกับตัวอย่างชุดเดียวกันและแก้เกณฑ์
- ทำบทตรวจ split 90 นาทีที่ลิงก์ไว้ แล้วแบ่งกลุ่มก่อนสร้าง augmentation เพื่อกันข้อมูลรั่ว
- เก็บรายการไฟล์/กลุ่ม/สิทธิ์ ตรวจ labels และพัก test โดยห้ามใช้เลือกค่าระหว่างทดลอง
ชิ้นงานและเกณฑ์ตรวจ
ส่ง: data card และ split manifest
เกณฑ์สำคัญ: ไม่พบ group ID ซ้ำข้าม split; ทุกแหล่งมีสิทธิ์ใช้ที่ตรวจได้; test ถูกพักไว้
แนบไฟล์ที่เปิดตรวจได้ วันที่ รุ่นข้อมูล และเหตุผลเมื่อยังสรุปไม่ได้ การทำใบงานสำเร็จไม่แทนผลทดลองกับโมเดล อุปกรณ์ หรือการประเมินทักษะจริง
เปิดแนวคำตอบหลังทำใบงาน
ภาพคนละไฟล์จากเที่ยวบินเดียวกันอาจคล้ายกันมาก จึงไม่ใช่หลักฐานอิสระ การตรวจไม่พบ group ซ้ำยังไม่ยืนยันว่าต่างสถานที่หรือปราศจากข้อมูลซ้ำทุกแบบ
แผนกิจกรรมสำหรับผู้สอน
ใช้เวลานอก lab 90 นาทีตรวจสิทธิ์และคุณภาพ กำกับภาพจริงที่มีสิทธิ์ และ peer review data card ก่อนเริ่มฝึกโมเดล
คำถามชวนทบทวน: ภาพคนละไฟล์จากเที่ยวบินเดียวกันนับเป็นข้อมูลอิสระหรือไม่?
| ชุดการเรียน | อธิบาย | ฝึก | ประเมิน | รวมสถานีอุปกรณ์ |
|---|---|---|---|---|
| AI และโดรน: จากภาพถึงการทดลองโมเดล | 105 นาที | 240 นาที | 75 นาที | 0 นาที |
เวลาสถานีอุปกรณ์เป็นส่วนหนึ่งของเวลารวมในแผน ไม่บวกซ้ำ ผู้สอนแยกผล PC กับ observed task และให้ผู้เรียนอธิบายงานรายคนก่อนเปิดแนวคำตอบ
ดูการจัดกิจกรรมครบสายและส่วนขยายพื้นฐาน →บรรณานุกรมและขอบเขตการอ้างอิง
ตรวจแหล่งเพิ่มเติม 9 กันยายน 2569 กรณีสมมติ ตัวเลข ใบงาน และเกณฑ์กิจกรรมเรียบเรียงใหม่โดย PK-Research
- scikit-learn — Cross-validation and grouped data
แยกชุดข้อมูลและคงกลุ่ม; การแบ่งระดับเที่ยวบินเป็นการประยุกต์ของบทนี้
- NIST — AI Risk Management Framework 1.0
กรอบจัดการความเสี่ยง AI แบบสมัครใจ ไม่รับรองความแม่นยำโมเดล
สูตรและแบบฝึกเพิ่มเติม · ปรับปรุง 2026-09-26
F19: แบ่งชุดครบแล้ว แต่เป็นข้อมูลใหม่จริงหรือไม่
กำหนดหน่วยนับก่อนคำนวณ บทนี้นับ ภาพ สำหรับสัดส่วน และใช้ เที่ยวบิน เป็นกลุ่ม ภาพติดกันจากเที่ยวบินเดียวต้องอยู่ split เดียว ถ้าต้องการประเมินพื้นที่ใหม่ ให้รวมเที่ยวบินจากพื้นที่เดียวกันเป็นกลุ่มระดับ site ก่อนแบ่ง
split_ratio = nsplit / N
prevalencec = nภาพที่มีคลาส c / N
overlap_count = |Gtrain ∩ Gtest|
| ตัวแปร | ความหมายและหน่วย | ช่วงและแหล่งค่า |
|---|---|---|
| N | จำนวนภาพทั้งหมดที่ผ่านเกณฑ์คัดเข้า ภาพ | จำนวนเต็ม > 0 จาก manifest รุ่นที่ล็อกไว้ |
| n_split | จำนวนภาพใน split ภาพ | จำนวนเต็ม 0–N; แต่ละภาพอยู่ split เดียว |
| n_ภาพที่มีคลาส c | ภาพที่มีคลาส c อย่างน้อยหนึ่งวัตถุ ภาพ | จำนวนเต็ม 0–N จาก labels; ภาพหนึ่งอาจมีหลายคลาส |
| G_train, G_test | เซตรหัสกลุ่มในแต่ละ split | ได้จาก flight_id หรือ site_id ที่ประกาศ |
| ratio, prevalence | สัดส่วน ไม่มีหน่วย | 0–1; คูณ 100 เมื่อต้องการ % |
| overlap_count | จำนวนกลุ่มร่วม กลุ่ม | จำนวนเต็ม ≥ 0; เกณฑ์ออกแบบคือ 0 สำหรับทุกคู่ split |
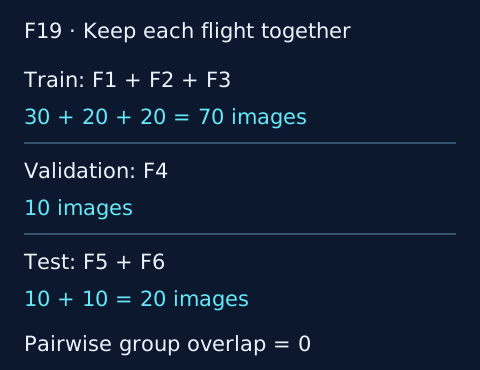
ภาพแสดง train = {F1,F2,F3}, validation = {F4}, test = {F5,F6} ทุกคู่มีส่วนร่วมว่าง แต่การตรวจรหัสกลุ่มอย่างเดียวยังไม่พบภาพ near-duplicate หรือพื้นที่เดียวกันที่ใช้รหัสต่างกัน
ตัวอย่างแทนค่าทีละขั้น
สมมติ F1/F2/F3 มี 30/20/20 ภาพ, F4 มี 10 ภาพ และ F5/F6 มี 10/10 ภาพ รวม N = 30+20+20+10+10+10 = 100 ภาพ ดังนั้น train = 70/100 = 70%, validation = 10/100 = 10%, test = 20/100 = 20% ผลรวม 100% และ overlap_count ของทั้งสามคู่ = 0 กลุ่ม สัดส่วนนี้เป็นตัวอย่าง ไม่ใช่สัดส่วนที่เหมาะกับทุกงาน
ถ้า 24 ภาพมีพัสดุอย่างน้อยหนึ่งชิ้น prevalence ของภาพที่มีพัสดุ = 24/100 = 24% แม้ labels จะมีพัสดุรวม 40 ชิ้นก็ตาม 40/100 = 0.4 ชิ้น/ภาพ คือความหนาแน่นวัตถุ ไม่ใช่ prevalence ตามนิยามนี้ งานหลายคลาสอาจมีผลรวม prevalence เกิน 100% เพราะภาพเดียวมีหลายคลาสได้ รายงานจำนวนภาพและวัตถุรายคลาสแยกกัน
สมมติฐานและขอบเขต
ตรวจ ID ซ้ำ, exact duplicate, near-duplicate, เวลา, scene และ site ก่อนแบ่ง เก็บ augmentation ของภาพต้นทางไว้ split เดียวกัน และ fit preprocessing ด้วย train เท่านั้น ใช้ validation เลือกโมเดลและ threshold; ใช้ test หลังล็อกการตัดสินใจ การแบ่งกลุ่มอาจทำให้สัดส่วนภาพไม่ตรงเป้าพอดี ให้รายงานค่าจริงแทนย้ายบางเฟรมข้ามกลุ่มเพื่อแต่งตัวเลข
หลักการแยกกลุ่มและ test set อ้างอิง scikit-learn: Cross-validation, grouped data ตรวจ 26 กันยายน 2569 ส่วน manifest และจำนวนในบทเป็นข้อมูลสังเคราะห์ที่ออกแบบเพื่อฝึก นิยาม overlap ตรวจเพียงรหัสกลุ่มที่ป้อน ไม่รับรองว่าข้อมูลไม่มี leakage ทุกชนิด
แบบฝึก
ย้ายภาพหนึ่งภาพของ F3 จาก train ไป test แล้วคำนวณสัดส่วนและ overlap ใหม่ การได้สัดส่วนใกล้เป้ายังรับรองการแยกกลุ่มหรือไม่?
เฉลย F19
Train = 69/100 = 69%, validation = 10%, test = 21% แต่ G_train ∩ G_test = {F3} จึง overlap_count = 1 กลุ่มและไม่ผ่านเกณฑ์กลุ่ม แม้ผลรวมยัง 100% คำตอบจำนวนต้องตรง; สัดส่วนยอมรับ ±0.01 จุดเปอร์เซ็นต์ หาก N = 0 ให้รายงานไม่มีข้อมูล ไม่หารด้วยศูนย์
ลงมือกับ บทตรวจ manifest และชุดฝึกเดิม แล้วอ่าน Precision/Recall และ IoU เพื่อระบุว่าประเมินภาพ วัตถุ หรือพิกเซล
ดาวน์โหลดชุดตรวจคำตอบสูตรพื้นฐาน (JSON) · ข้อมูลสังเคราะห์สำหรับเปรียบเทียบคำตอบและหน่วย